pplx-decider v1.1 a obtenu 643/669 aux tests de décision clinique, surpassant le score de 628 de Jev, avec un coût par décision 42% inférieur et une vitesse similaire. Les poids sont téléchargeables pour un déploiement intra-hospitalier.
Mr Vu présente un aperçu de la recherche de médicaments transfrontalière, avec JEV pour la planification de la recherche et EmbeddingGemma 2 pour les embeddings.
Ce post présente les coûts et vitesses de Jev et d'autres modèles sur des tâches de décision clinique, compare le coût total de 9 API et note que le modèle local de 3 Go le plus rapide répond en 284 ms.
Dans la démo, 20 patients attendent avec 3 médecins et 3 salles. Quand une salle se libère, Jev (TypeSafe Choice) sélectionne le patient suivant, en priorisant le niveau ESI le plus grave, et en cas d'égalité, celui arrivé en premier.
Un résident en radiologie a construit JevRad (usage éducatif uniquement) avec le modèle Jev de TypeSafe. Après la description d'un patient, Jev identifie le scénario ACR en 0,5 s et sélectionne les examens d'imagerie les plus appropriés. Link
Udit Akhouri a annoncé Mores Research, un laboratoire utilisant des classificateurs comportementaux comme Jev de TypeSafe AI pour effectuer une cartographie des intentions comportementales en temps réel sur un long horizon pour la santé mentale pédiatrique.
OpenMed a testé sur quatre notes médicales fictives : Jev a obtenu 16/16, Laya 13/16 ; sur les questions de conflit médicamenteux 4/4 contre 2/4. L'auteur précise qu'il s'agit d'un diagnostic utile, pas d'une estimation de précision clinique.
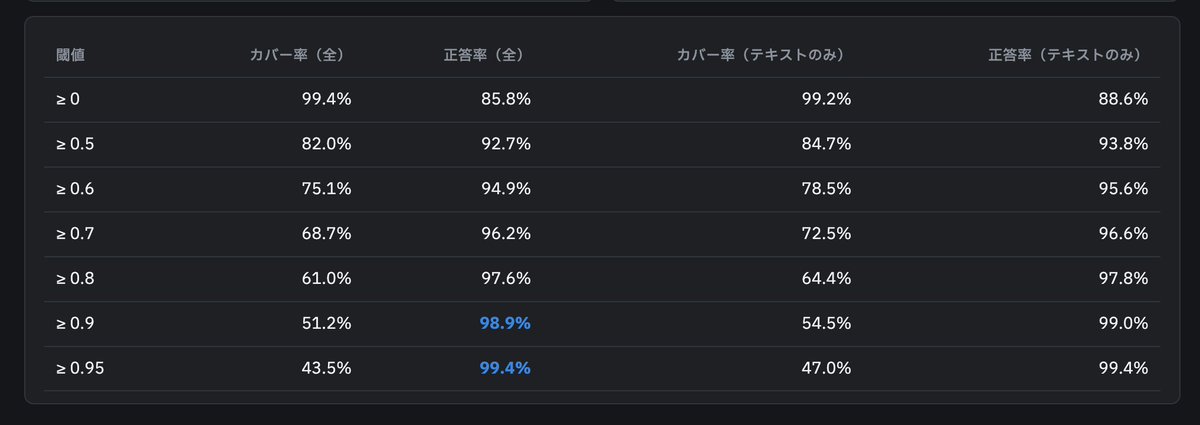
Un utilisateur a testé Jev sur le benchmark de QA médicale igakuQA : 2 000 questions résolues en environ 80 secondes pour 0,04 $ ; la précision texte uniquement était de 88,6 %, comparable à GPT-4o ; l'utilisation de seuils de confidence a amélioré la précision.
Inspiré par Jev et la communauté open source, MedJev transforme des notes cliniques en texte libre en champs structurés et fonctionne sur GPU grand public.
Le post explique que Jev n'est pas un autre chatbot : il est conçu pour choisir, noter et router, tandis qu'un LLM rédige, résume et converse. Dans une clinique, le LLM gère le langage, Jev vérifie ou route la sortie, et le personnel garde le contrôle.