


问题设计比模型更关键:Jev vs Laya测试
同一430例测试中,展示证据时Jev漏过68-92%的虚假代理报告,Laya漏过84-88%;改为直接提问后,Jev仅漏过约1%的错误计数和文件。实验结果表明提问方式的影响大于模型选择。 链接

THE JEV GUIDE · CURATED EDITION
TypeSafe Jev 的发布、原理、演示与社区实践,按主题整理。每条内容都可回到 X 原帖核对。
人工精选 · 非全量收录 · 手动更新
Sponsors
这些产品赞助了本目录。 把你的产品放上来
同一430例测试中,展示证据时Jev漏过68-92%的虚假代理报告,Laya漏过84-88%;改为直接提问后,Jev仅漏过约1%的错误计数和文件。实验结果表明提问方式的影响大于模型选择。 链接
推荐阅读Sebastian Raschka的文章,回顾文本分类技术的发展历程,并介绍了TypeSafe AI的决策模型Jev。 链接

该论文研究了结构化决策模型(如Jev)在仇恨言论审核任务中的准确性和效率,为内容审核提供评估参考。 链接

用户指出 Jev-as-Judge 存在严重性和宽容性偏差,需要移除这些偏差才能用于高风险的 AI 评估。

帖子询问是否有人将Jev风格模型用作过程奖励学习(PRL)中的评判者,并指出更好的评判者可能推动PRL复兴,更多监督有助于学习。

信息流里每 16 张、每一页都有一张。每周 $50,任意一周可停。
James Briggs解析TypeSafe AI的Jev模型,并对比OpenJev(Von)和小型GLiNER模型,发现仅74M参数的GLiNER在Doom基准上表现惊人,甚至超过Jev。

以科学视角介绍Jev,讨论快速AI并非能力下降,并附完整视频链接。 链接

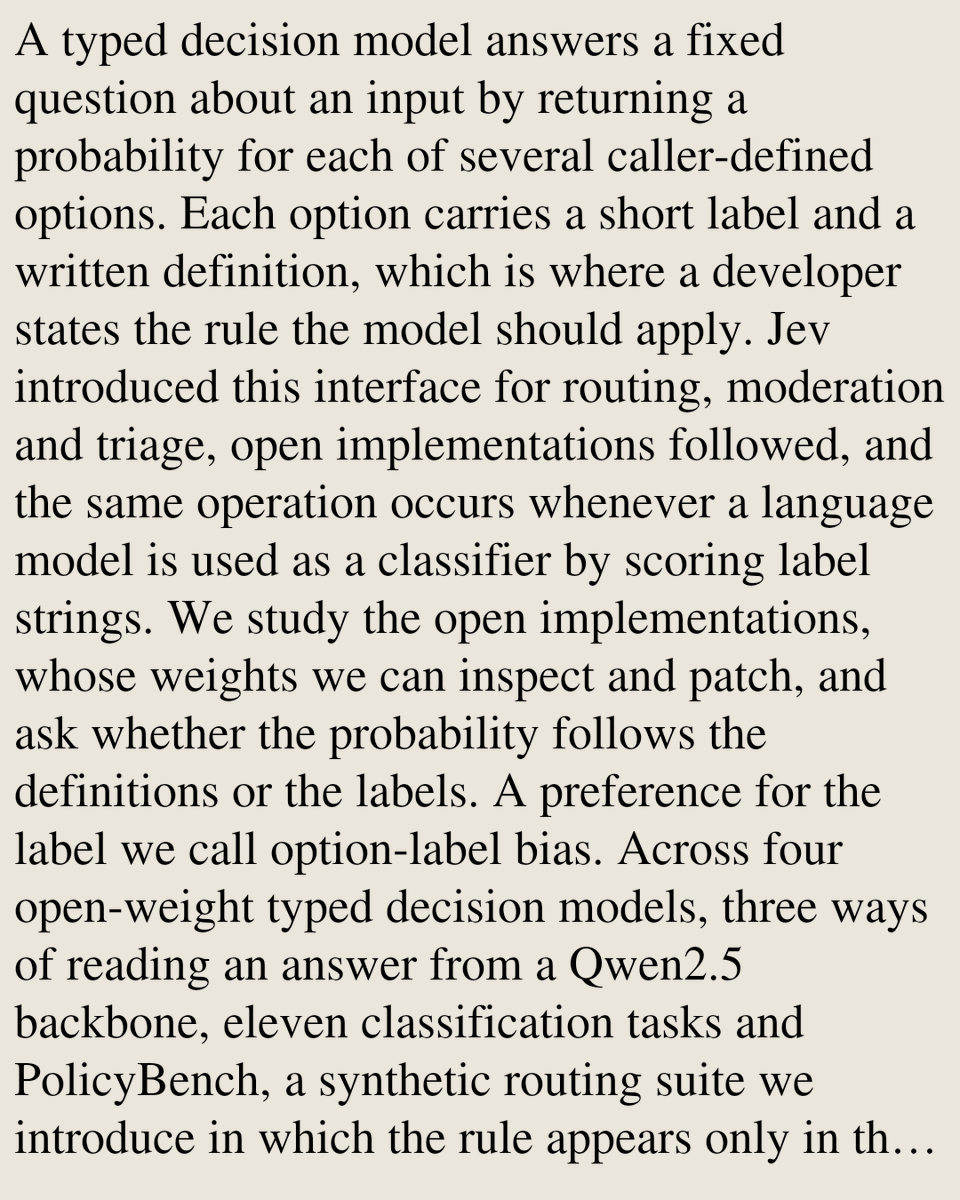
该帖子分享了一篇arXiv论文《Labels Override Definitions in Jev-Style Typed Decision Models》,作者为Seyedarmin Azizi、Erfan Baghaei Potraghloo和Massoud Pedram。 链接
用户分享了Jev及类似模型在多种任务上的评估结果和评估指标概览。


研究人员评估了两个 System-1 决策模型——开源 Laya 和托管式 Jev——在 11 个智能体决策点上的表现,使用 7,283 个基础用例及 6,640 个鲁棒性变体。结果显示 Jev 胜出。

该研究提出将Jev模型引入Semantic SQL,利用LLM等模型判断文本语义,用于SQL的筛选和JOIN条件,以解决逐行判断带来的时间和费用开销问题。

介绍一篇关于 Chinese-Jev 的学术论文,旨在将 TypeSafe 的 System One 模型扩展到中文语言任务,涵盖自然语言处理和计算机视觉等方向。 链接
