


开放模型在临床决策上超越Jev
pplx-decider v1.1在临床决策测试中取得643/669的准确率,高于Jev的628,且每次决策成本降低42%,速度相近,权重可下载并可在医院内部部署。

THE JEV GUIDE · CURATED EDITION
TypeSafe Jev 的发布、原理、演示与社区实践,按主题整理。每条内容都可回到 X 原帖核对。
人工精选 · 非全量收录 · 手动更新
Sponsors
这些产品赞助了本目录。 把你的产品放上来
pplx-decider v1.1在临床决策测试中取得643/669的准确率,高于Jev的628,且每次决策成本降低42%,速度相近,权重可下载并可在医院内部部署。
Mr Vu发布了跨国药物搜索的预览,由JEV规划搜索流程,并使用EmbeddingGemma 2提供嵌入支持。

该帖展示了 Jev 等模型在临床决策任务中的成本与速度数据,对比 9 个 API 的总成本,并指出最快的本地 3GB 模型响应时间达 284 毫秒。

演示中,20名患者等待,3名医生、3间病房。当病房空出时,Jev(TypeSafe Choice)根据 ESI 严重程度优先、先到先得的原则选择下一位患者。

一位放射科住院医师使用 TypeSafe 的 Jev 模型构建了 JevRad(仅限教育用途)。用户描述患者情况后,Jev 在 0.5 秒内匹配 ACR 场景并推荐最合适的影像检查。 链接

信息流里每 16 张、每一页都有一张。每周 $50,任意一周可停。
Udit Akhouri 宣布成立 Mores Research 实验室,利用 TypeSafe AI 的 Jev 等行为分类器,开展儿科心理健康的长时程实时行为意图映射研究。

OpenMed 使用四个虚构医疗笔记进行测试,Jev 得分 16/16,Laya 13/16;在药物冲突问题上 Jev 4/4,Laya 2/4。作者强调这是有用的诊断,而非临床准确性评估。

Ali Madad在犹他州护理研究会议上展示了使用 TypeSafe AI 的 Jev 重建的 givecareapp InvisibleBench,应用于照护研究。

Jev 模型展示读取 CT 扫描的应用,可能用于医疗影像分析。

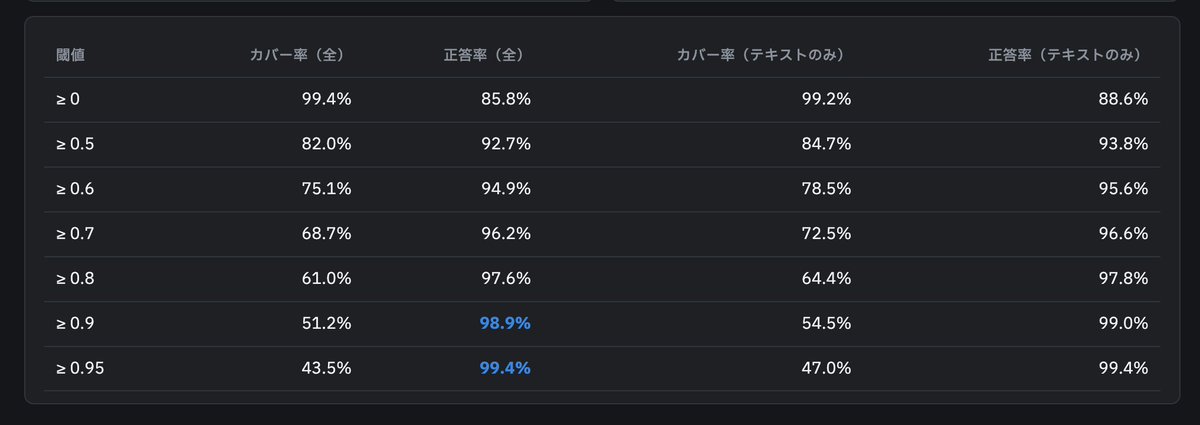
用户用医学QA基准igakuQA测试Jev:2000题约80秒完成,花费0.04美元;文本限定正解率88.6%,与GPT-4o相当;使用confidence截断可进一步提升正确率。
受 Jev 和开源社区启发,MedJev 可将临床自由文本笔记转换为结构化字段,并在消费级 GPU 上运行。

帖子指出 Jev 不是聊天机器人,而是负责选择、评分和路由;LLM 负责起草、总结和对话。在诊所中,LLM 处理语言,Jev 检查或路由输出,员工保持控制。
