Jev im Vergleich zu textgenerierenden Modellen
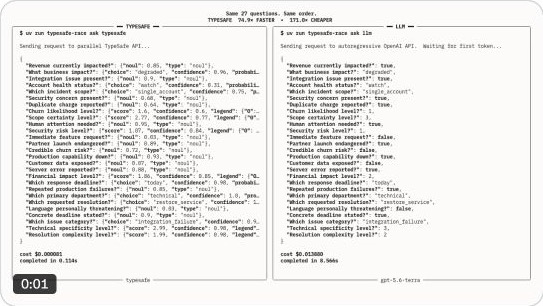
Jev erzeugt keinen freien Text. Ein Vergleichsvideo zeigt den Unterschied zwischen paralleler Entscheidungsfindung und tokenweiser Texterzeugung.
Mit einer Schwelle, bei der höchstens 1 von 100 durchgelassenen Antworten falsch ist, lässt Jev 93 % ohne menschliche Prüfung durch, OpenAI 66 %; große allgemeine Modelle erreichen 98 %, sind aber etwa 10-mal langsamer.
The number that matters we think: how many answers can skip a human check? With each model's cut-off set so at most 1 in 100 let through are wrong, Jev lets 93% through and OpenAI's 66%. Big general models reach 98%, but they're 10× slower.

Jev erzeugt keinen freien Text. Ein Vergleichsvideo zeigt den Unterschied zwischen paralleler Entscheidungsfindung und tokenweiser Texterzeugung.
Der Launch Thread erklärt Code plus AI Workflow Evaluationen, den angekündigten Eingabepreis und kostenlose Ausgabetokens.


Dieses Modell ist für Entscheidungsfindung statt Textgenerierung konzipiert und gibt Wahrscheinlichkeiten für jede Option parallel aus, anstatt Antworten Token für Token zu liefern. Der Autor zeigt ein vereinfachtes Beispiel für normale LLMs im Vergleich zu diesem Jev-Modell.
