Jev face aux modèles générateurs de texte
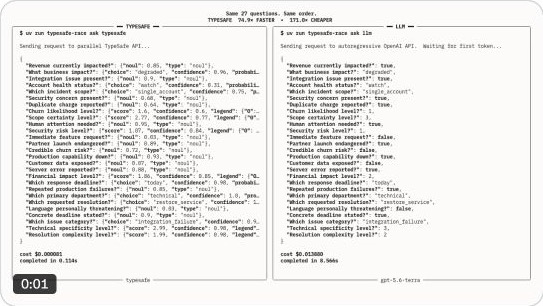
Jev ne génère pas de texte libre. Une vidéo côte à côte compare la décision parallèle avec la génération token par token.
Avec un seuil fixé pour qu'au plus 1 réponse sur 100 laissée passer soit erronée, Jev laisse passer 93 % des réponses sans vérification humaine, contre 66 % pour OpenAI ; les grands modèles généralistes atteignent 98 % mais sont 10 fois plus lents.
The number that matters we think: how many answers can skip a human check? With each model's cut-off set so at most 1 in 100 let through are wrong, Jev lets 93% through and OpenAI's 66%. Big general models reach 98%, but they're 10× slower.

Jev ne génère pas de texte libre. Une vidéo côte à côte compare la décision parallèle avec la génération token par token.
Le fil de lancement explique les évaluations de workflows code + AI, le prix d’entrée annoncé et les tokens de sortie gratuits.


Ce modèle est conçu pour la prise de décision plutôt que la génération de texte, produisant des probabilités pour chaque option en parallèle au lieu de réponses token par token. L'auteur présente un exemple simplifié comparant les LLM classiques à ce modèle Jev.
