pplx-decider v1.1 erreichte 643 von 669 bei klinischen Entscheidungstests und übertraf damit Jevs 628, bei 42 % geringeren Kosten pro Entscheidung und ähnlicher Geschwindigkeit. Die Gewichte sind herunterladbar und können im Krankenhaus ausgeführt werden.
Dieser Beitrag zeigt Kosten- und Geschwindigkeitsdaten von Jev und anderen Modellen für klinische Entscheidungsaufgaben, vergleicht die Gesamtkosten von 9 APIs und merkt an, dass das schnellste lokale 3-GB-Modell in 284 ms antwortet.
In der Demo warten 20 Patienten auf 3 Ärzte und 3 Räume. Wenn ein Raum frei wird, wählt Jev (TypeSafe Choice) den nächsten Patienten aus, zuerst nach dem schwersten ESI-Level, bei Gleichstand nach früherer Ankunft.
Ein Radiologie-Assistenzarzt hat mit Jev von TypeSafe JevRad (nur zu Bildungszwecken) erstellt. Nach der Beschreibung eines Patienten wählt Jev in 0,5 s das ACR-Szenario aus und empfiehlt die geeignetsten Bildgebungsuntersuchungen. Link
Udit Akhouri hat Mores Research angekündigt, ein Labor, das Verhaltensklassifikatoren wie Jev von TypeSafe AI nutzt, um langfristiges Echtzeit-Verhaltensabsichts-Mapping für pädiatrische psychische Gesundheit durchzuführen.
OpenMed testete vier fiktive medizinische Notizen: Jev erzielte 16/16, Laya 13/16; bei Medikationskonflikt-Fragen 4/4 vs. 2/4. Der Autor betont, dass dies ein nützliches Diagnosewerkzeug ist, keine klinische Genauigkeitsschätzung.
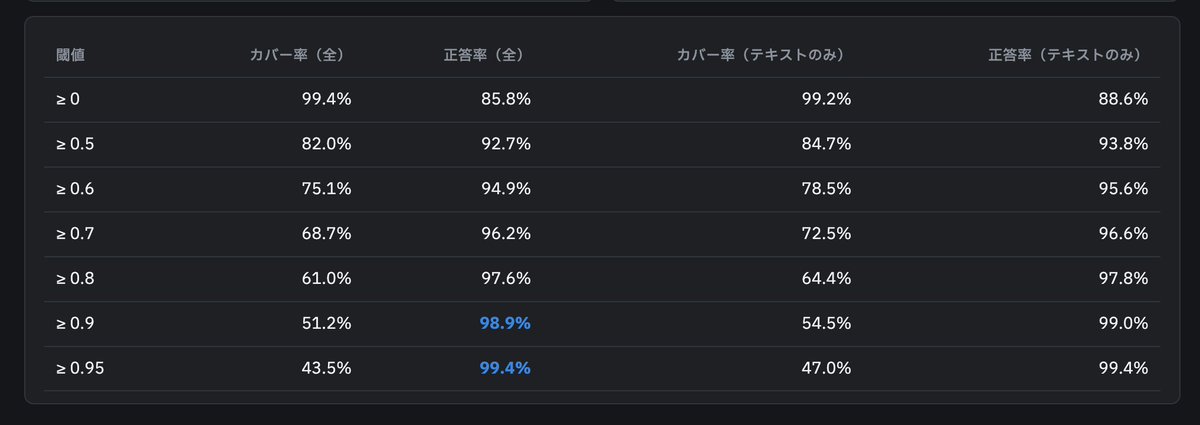
Ein Nutzer testete Jev auf dem medizinischen QA-Benchmark igakuQA: 2.000 Fragen in etwa 80 Sekunden für 0,04 $ gelöst; die reine Textgenauigkeit lag bei 88,6 % und damit auf GPT-4o-Niveau; Confidence-Schwellenwerte verbesserten die Genauigkeit weiter.
Der Beitrag erklärt, dass Jev kein weiterer Chatbot ist, sondern auswählt, bewertet und weiterleitet, während ein LLM entwirft, zusammenfasst und konversiert. In einer Klinik übernimmt das LLM die Sprache, Jev prüft oder leitet die Ausgabe weiter, und das Personal behält die Kontrolle.