


오픈 모델, 임상 결정에서 Jev 능가
pplx-decider v1.1이 임상 결정 테스트에서 643/669을 기록하며 Jev의 628을 능가했습니다. 결정당 비용은 42% 낮고 속도는 비슷하며, 가중치를 다운로드해 병원 내에서 실행할 수 있습니다.

THE JEV GUIDE · CURATED EDITION
TypeSafe Jev의 출시 소식, 설명, 데모, 커뮤니티 프로젝트를 주제별로 정리했습니다. 모든 항목은 X 원본 게시물로 연결됩니다.
선별 큐레이션 · 전체 수집 아님 · 수동 업데이트
Sponsors
이 제품들이 이 디렉터리를 후원합니다. 내 제품도 올리기
pplx-decider v1.1이 임상 결정 테스트에서 643/669을 기록하며 Jev의 628을 능가했습니다. 결정당 비용은 42% 낮고 속도는 비슷하며, 가중치를 다운로드해 병원 내에서 실행할 수 있습니다.
Mr Vu가 JEV의 검색 계획과 EmbeddingGemma 2의 임베딩을 활용한 국가 간 의약품 검색 미리보기를 공개했습니다.

이 게시물은 임상 결정 작업에서 Jev 및 기타 모델의 비용과 속도 데이터를 공유하고, 9개 API의 총 비용을 비교하며, 가장 빠른 3GB 로컬 모델이 284ms로 응답한다고 언급합니다.

데모에서 20명의 환자가 3명의 의사와 3개의 병실을 기다립니다. 방이 비면 Jev(TypeSafe Choice)가 가장 중증도가 높은 ESI 수준을 우선하고, 동률일 경우 먼저 도착한 환자를 선택합니다.

방사선과 전공의가 TypeSafe의 Jev 모델을 사용하여 JevRad(교육용)를 구축했습니다. 환자 정보를 입력하면 Jev가 0.5초 만에 ACR 시나리오를 선택하고 가장 적절한 영상 검사를 추천합니다. Link

One card in the feed, every sixteen, on every page of it. $50 a week, cancel any week.
Udit Akhouri가 Mores Research 연구소를 발표했습니다. TypeSafe AI의 Jev와 같은 행동 분류기를 사용하여 소아 정신 건강을 위한 장기 실시간 행동 의도 매핑을 연구합니다.

OpenMed가 4개의 가상 의료 메모로 테스트한 결과, Jev는 16/16, Laya는 13/16을 기록했습니다. 약물 충돌 질문에서는 4/4 대 2/4였습니다. 저자는 이것이 임상 정확도 추정이 아닌 유용한 진단이라고 언급했습니다.

Ali Madad가 유타주 케어 연구 컨퍼런스에서 TypeSafe AI의 Jev로 재구축한 givecareapp InvisibleBench를 발표했습니다.

Jev 모델이 CT 스캔 판독을 시연하며 의료 영상 분석에 활용될 수 있습니다.

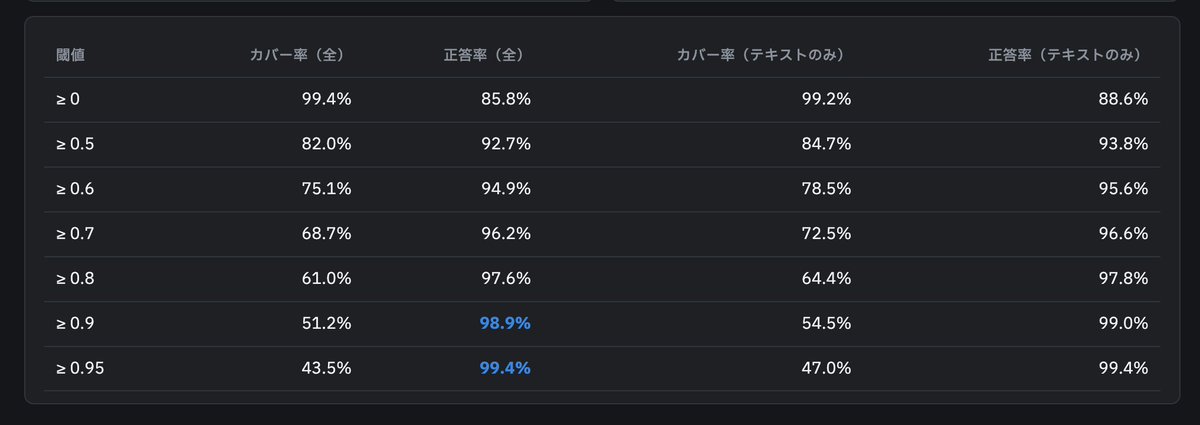
사용자가 의료 QA 벤치마크 igakuQA에서 Jev를 테스트했습니다. 2000문제를 약 80초 만에 풀고 비용은 0.04달러였으며, 텍스트 한정 정확도는 88.6%로 GPT-4o와 비슷했습니다. confidence 컷오프를 사용하면 정확도가 더 높아졌습니다.
Jev와 오픈소스 커뮤니티에서 영감을 받은 MedJev는 자유 텍스트 임상 노트를 구조화된 필드로 변환하며 소비자용 GPU에서 실행됩니다.

Jev는 또 다른 챗봇이 아니라 선택, 점수화, 라우팅을 위해 만들어졌고, LLM은 초안 작성, 요약, 대화를 담당한다. 클리닉에서는 LLM이 언어를 처리하고 Jev가 출력을 확인하거나 라우팅하며 직원이 통제권을 유지한다.
